联系我们

研究 ▸ Evidence archive

证据档案。

CPF(Causal Perturbation Framework,因果扰动框架)用受控扰动查失败的原因。这里按证据状态列出我们查过的问题:正结果、负结果和没做完的并排放,每一条都写明能说到哪一步。这不是成果展示。

OpenVLA #303 相关公开复现
94.78% → 5.22%
115 帧的离线夹爪误判率,降低 89.57 个百分点
LeRobot #2605
4281× → 0
受控训练轨迹偏差(conv1 参数差增长),对齐归一化输入后
robomimic #292
1 → 3
1 次前向,按顺序执行 3 步环境动作;任务级修复未验证
CPF v2.12 框架测试
112 / 112
18 项新测试 + 94 项 v2.11 回归测试;框架 / 协议测试,不是机器人任务表现

以上结果都来自受控评估设置,不代表普遍的物理或因果智能。These results are from controlled evaluation settings and do not establish universal physical or causal intelligence.

01 ▸ 状态总表

正结果、负结果,
和没做完的。

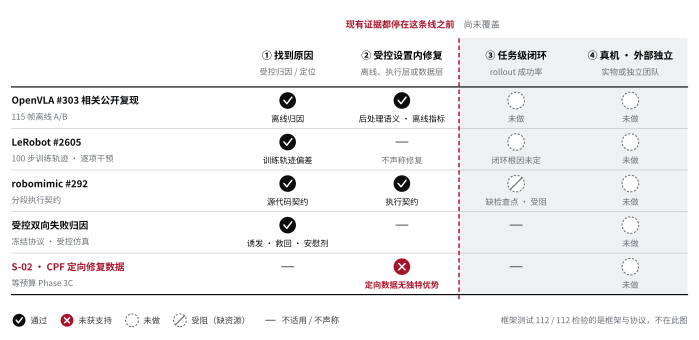
横着看是证据的四个层级,从「找到原因」到「真机与外部独立验证」。每一条走到哪一格、在哪一格停下,一眼就能看出来;负结果和被拦下的验证画在同一张图里。

证据地图:五个条目在四个证据层级上的状态。OpenVLA 相关公开复现在找到原因和受控修复两格通过;LeRobot 在找到原因一格通过,不声称修复;robomimic 在找到原因和执行契约两格通过,任务级受阻;受控双向失败归因在找到原因一格通过;S-02 定向修复数据在受控修复一格未获支持。任务级闭环与真机、外部独立验证两列全部未做或受阻,红色虚线标出现有证据的边界。
Fig. 1 | 证据地图。行:证据档案里的五个条目;列:四个证据层级。黑色对勾:通过;红色叉:未获支持;虚线圆:未做;带斜线的虚线圆:缺资源、受阻;短横:不适用或不声称。红色虚线右边的两列目前没有任何条目覆盖。图中不含数值,状态与下方文字版逐条对应。
文字版状态总表 · 8 行,含示例研究与真机验证
项目证据状态能说到哪一步
受控双向失败归因冻结协议下的受控仿真评估已验证 · 受控只在受控仿真、冻结协议下成立
S-02 · CPF 定向修复数据等预算 Phase 3C 受控比较未获支持不声称定向数据更有效,不声称自动修复
OpenVLA #303 相关公开复现115 帧受控 A/B(后处理干预)离线归因通过只针对公开复现路径;模型未被修复
LeRobot #2605100 步受控训练轨迹 A/B 与逐项干预训练轨迹因果定位闭环任务根因尚未确定
robomimic #292分段执行契约测试机制通过 · 任务级未验证缺检查点与数据,任务级 A/B 受阻
CPF v2.12 框架测试18 项新测试 + 94 项 v2.11 回归测试112 / 112 通过框架 / 协议测试,不是机器人任务表现
S-01 · 透明方块(示例)预注册草稿未执行只说明比较结构
真机与外部独立验证—尚未完成不声称已完成真实世界或外部独立验证

02 ▸ 外部案例

三个公开问题,
各查到哪一步。

三个案例都来自公开的 issue,不是 EthSeq 提出的问题,也不代表相关项目与 EthSeq 合作或认可。每个案例只改一处,门槛事先写定。

案例 A

OpenVLA #303 相关公开复现的分析

离线夹爪误判 · 受控后处理干预
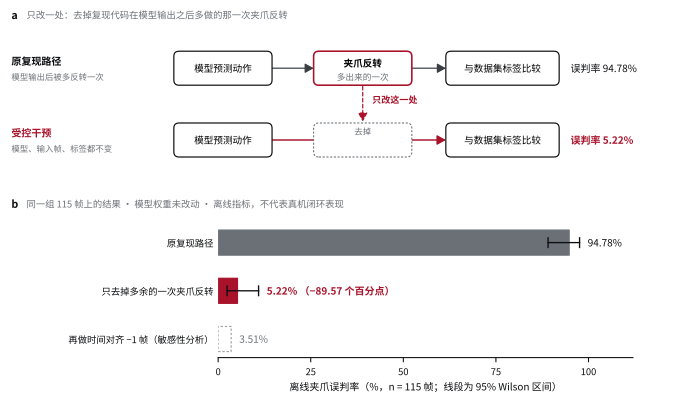
两部分。a:流程示意。原复现路径是模型预测动作、夹爪反转(多出来的一次)、与数据集标签比较,误判率 94.78%;受控干预只去掉那一次反转,误判率 5.22%。b:横向柱状图,原复现路径 94.78%,去掉多余反转后 5.22%,再做时间对齐后 3.51%(敏感性分析)。
Fig. 2 | OpenVLA #303 相关公开复现的受控后处理干预。a,干预只改了一处:去掉复现代码在模型输出之后多做的那一次夹爪反转;模型权重、输入帧和标签都不变(流程示意,不含数据)。b,同一组 115 帧上的离线夹爪误判率。灰:原复现路径;红:只去掉多余的一次反转;虚线框:在此基础上做 −1 帧时间对齐,只作敏感性分析。线段为 95% Wilson 区间,由百分比对应的帧数计算。
问题
一份与 OpenVLA #303 相关的公开复现,报告了 Fractal / RT-1 数据上大比例的夹爪误判。
预注册假设
复现代码在模型给出动作之后,多做了一次夹爪反转;这个后处理语义错误是离线误判的主要原因。
干预
只去掉复现路径里那一次多余的反转。模型预测和其余评估路径都不变。
结果
同一组 115 帧上,误判率从 94.78% 降到 5.22%,降低 89.57 个百分点。在 ±5 帧内做时间对齐(最优为 −1 帧)后是 3.51%,只作敏感性分析,不作主数字。
判定
失败归因 通过 后处理语义修复 通过 离线指标 通过

结论边界

  • 这是对一份与 OpenVLA #303 相关的公开复现的分析,不代表 CPF 验证了 OpenVLA,也不代表与 OpenVLA 的合作或认可。
  • 没有改动或重训任何模型权重;OpenVLA 模型本身没有被修复。
  • 没有做同协议的真机闭环评估,不声称真机表现有改善。
  • 单个案例,不说明 CPF 能自动修复机器人。
案例 B

LeRobot #2605:受控训练轨迹的失败归因

训练轨迹偏差 · 逐项受控干预

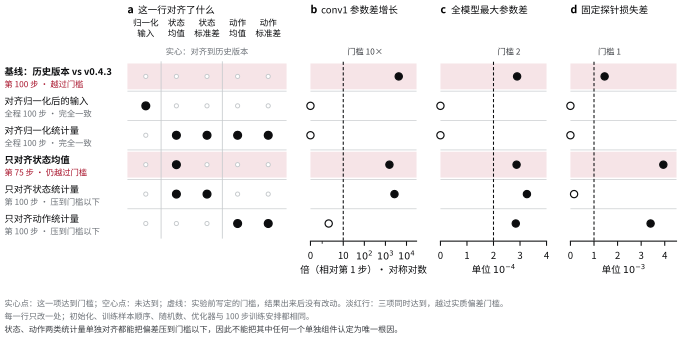
四个面板。a:设计矩阵,六行条件各自对齐了哪些量(归一化输入、状态均值、状态标准差、动作均值、动作标准差)。b 到 d:三项门槛指标的点图,虚线为实验前写定的门槛。基线和只对齐状态均值两行三项都达到门槛,越过实质偏差门槛;对齐归一化输入或全部统计量两行三项都为 0;只对齐状态统计量时探针损失差低于门槛,只对齐动作统计量时 conv1 参数差增长低于门槛,两行都压到门槛以下。
Fig. 3 | LeRobot #2605 的受控干预漏斗。a,每一行只改一处,实心点是这一行对齐到历史版本的量。b–d,决定性里程碑上的三项门槛指标:越过门槛的那一步,或第 100 步。实心点表示这一项达到门槛,虚线是实验前写定的门槛;三项同时达到才算越过实质偏差门槛(淡红行)。b 用对称对数轴,c、d 用线性轴;0 表示与历史版本完全一致。
问题
公开 issue 报告 ACT 策略在 aloha-gym 上的表现低于预期。我们先查一个更窄、能受控的问题:历史版本和 v0.4.3 的训练轨迹,为什么会分开。
固定条件
同一初始化、训练样本顺序、随机数安排、优化器与 ACT 配置,训练 100 步。「实质偏差门槛」由三项指标同时满足构成,实验前写定,之后不改。
漏斗
  1. 基线:训练轨迹出现实质偏差,到第 100 步越过门槛。
  2. 对齐归一化后的输入:偏差被完全压制,100 步内各项指标完全一致。
  3. 对齐归一化统计量(状态 + 动作):偏差同样被完全压制。
  4. 只对齐状态均值:不足以压制,偏差在第 75 步仍越过门槛。
  5. 只对齐状态统计量,或只对齐动作统计量(各自均值 + 标准差):都能把偏差压到门槛以下。
结论
受控训练轨迹上的失败归因 / 因果定位:这段训练轨迹偏差被定位到归一化统计量。

结论边界

  • 这是训练轨迹层面的受控归因,不是公开 issue 中任务成功率下降的根因;那个根因尚未确定。
  • 状态、动作两类统计量单独干预都能把偏差压到门槛以下,因此不能把其中任何一个单独组件认定为唯一根因。
  • 不声称自动修复,也不声称闭环任务表现已恢复。
案例 C

robomimic #292:分段执行契约

源代码契约归因 · 执行层验证

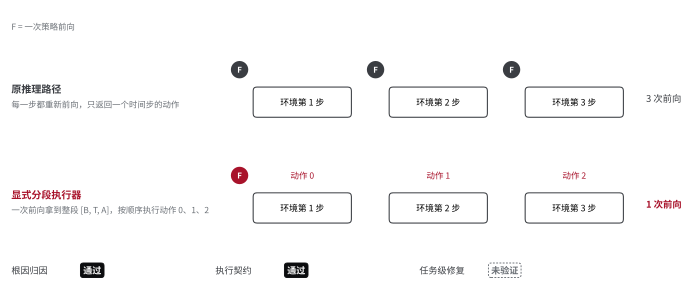
示意图:原推理路径每个环境步都做一次前向,共 3 次;显式分段执行器 1 次前向后按顺序执行动作 0、1、2。下方为三项判定:根因归因通过、执行契约通过、任务级修复未验证。
Fig. 4 | robomimic #292 的执行契约。上:原推理路径,每一步重新前向;下:显式分段执行器,一次前向执行三步。任务级修复需要同检查点、同环境、同种子的 A/B,目前做不了。
问题
用户把 BC-Transformer 配成输出动作序列,但同一段里的动作几乎不变,段与段之间跳变。
归因
预测未来动作的设置改变了训练目标,但原推理路径本身没有「按顺序执行整段动作」的执行器,每一步只返回一个时间步。
干预
显式分段执行器:一次前向拿到整段动作,排队,每个环境步返回一个,用完再前向。
结果
1 次策略前向,按顺序给出 3 个连续的环境动作 [0, 1, 2]。
判定
根因归因 通过 执行契约 通过 任务级 rollout 修复 未验证

结论边界

  • 验证的是执行机制,不是原作者机器人任务的成功率。
  • 公开讨论里没有对应的检查点、训练数据或 rollout 记录,任务级 A/B 受阻;缺资源记为受阻,不记为实验失败。
  • 不说明 CPF 能自动修复机器人。

03 ▸ 受控评估

一条通过了,
一条没有。

两条结论都来自冻结协议下的受控评估。具体任务与数值属于内部资料,所以图里只画比较怎么设计、结论落在哪一边。

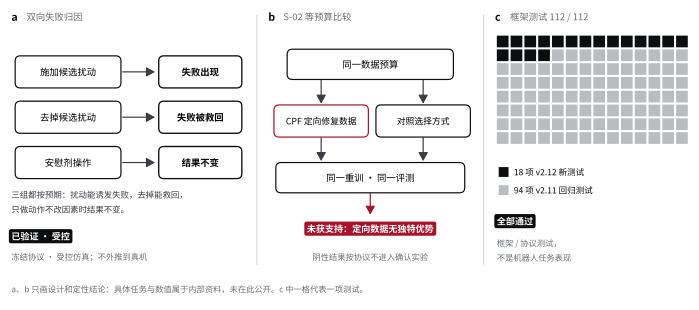
三部分。a:双向失败归因的三组对照,施加候选扰动时失败出现,去掉候选扰动时失败被救回,安慰剂操作时结果不变,标记已验证、受控。b:S-02 等预算比较,同一数据预算分给 CPF 定向修复数据和对照选择方式,经过同一重训与评测,判定未获支持,定向数据没有独特优势。c:112 个小方格,18 个深色为 v2.12 新测试,94 个浅色为 v2.11 回归测试,全部通过。
Fig. 5 | 受控评估的三块证据。a,双向失败归因:三组对照都符合预期(已验证,受控仿真、冻结协议)。b,S-02:同一数据预算下比较 CPF 定向修复数据与对照选择方式,定向数据没有表现出独特优势(未获支持)。c,CPF v2.12 框架测试,一格一项:18 项新测试与 94 项回归测试全部通过;这是框架与协议测试,不是机器人任务表现。a、b 只画设计与定性结论。

已验证 · 受控

受控双向失败归因

在冻结协议下的受控仿真评估中,双向失败归因通过:施加候选扰动能诱发失败,去掉它能把失败救回来,安慰剂操作不改变结果。

Controlled bidirectional failure attribution was validated under a frozen protocol.

边界:只在受控仿真、冻结协议下成立,不外推到真机或其他设置。

未获支持

S-02 · CPF 定向修复数据

在当前等预算的受控比较(Phase 3C)中,CPF 定向的修复数据没有表现出独特优势。按协议,阴性结果不进入下一阶段的确认实验。

An equal-budget Phase 3C comparison did not support a unique advantage for CPF-directed repair data. Not supported in the current equal-budget controlled evaluation.

因此我们不声称定向数据比随机或其他选择方式更有效,也不声称自动修复;DataGap 只作假设,DataPlan 只作提议。

112 / 112 通过

CPF v2.12 框架测试

18 项 v2.12 新测试与 94 项 v2.11 回归测试全部通过,覆盖证据完整性、失败即停(fail-closed)、适配器、检查点兼容和科学能力边界。

这是框架 / 协议测试,不是机器人任务表现。

04 ▸ 研究回路

回路上每一段,
现在到了哪儿。

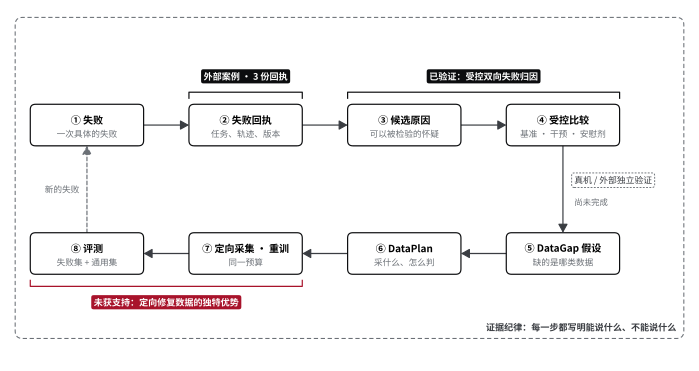
找原因的那半圈有外部案例和受控验证;补数据的那半圈,目前的受控比较没有支持定向数据的独特优势。

研究回路:失败、失败回执、候选原因、受控比较、DataGap 假设、DataPlan、定向采集与重训、评测,再回到新的失败;各段标注目前的证据状态。
Fig. 6 | 研究回路与各段的证据状态。墨色标签:已有证据支持;红色标签:负结果;虚线框:尚未完成。

05 ▸ 证据纪律

证据档案,
不是成功展示。

正结果、负结果和被拦下的结果并列。每一步只说它撑得住的话。

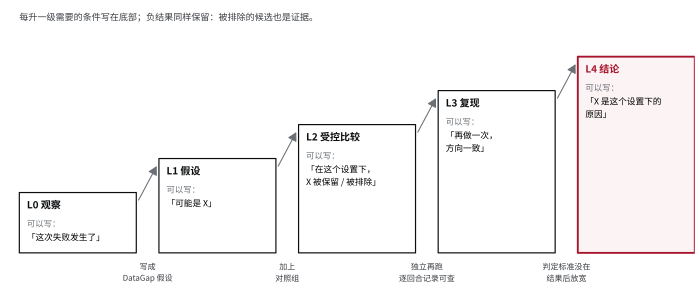
证据阶梯:L0 观察、L1 假设、L2 受控比较、L3 复现、L4 结论,每一级写明可以写什么,以及升到下一级需要的条件。
Fig. 7 | 证据阶梯。每一级下面写着这一级最多可以说什么;升到下一级的条件写在台阶之间。
  1. 01没有验证过的假设,标成「DataGap Hypothesis」,不写成结论。
  2. 02单次实验的结果,不包装成稳定的规律。
  3. 03数据预算不同的实验,不直接比较。
  4. 04随机条件不同的结果,不当成严格的 A/B/C 对照。
  5. 05结果出来以后不放宽判定标准;负结果照样保留、照样公开。

合作研究

有一类反复出现的失败?

带上任务范围和几段失败轨迹。我们先写定门槛,再动手查;查到哪一步,就写到哪一步。

想看比较怎么设计,可以先读示例研究计划:S-01 透明方块(预注册草稿,未执行)。

写信给我们: